預算情境模擬工具 Scenario Planner 做了什麼
依 GitHub 上 google/meridian 的官方公告,Meridian Scenario Planner 隨 1.4.0 版以公開 Beta 釋出。它由 Looker Studio 驅動,是 Google 開源 MMM 框架 Meridian 的無程式碼介面。
行銷組合模型(MMM)用歷史的廣告花費與銷售總量做統計建模。它估算每個管道對業績貢獻了多少。因為不追蹤個人,所以不需要 Cookie 或像素。
先講 Meridian 本身。Google 在 於官方部落格宣布,Meridian 開放給所有廣告主使用。同一篇公告提到,已有超過 20 家量測合作夥伴完成 Meridian 的訓練與認證。開源的好處很直接:模型怎麼算的,大家都看得到。
問題是開源不等於好用。原本的 Meridian 要寫 Python,要懂貝氏統計。行銷部門多半沒有這種人手。所以模型雖然免費,真正跑起來的團隊並不多。
Scenario Planner 補的就是這一塊。GitHub 公告的發布日期是 。公告列出三個用途:看懂模型結果、試算不同的預算情境、即時最佳化未來的花費。做好的報表可以直接用連結分享給規劃團隊。
行銷媒體 MarTech 在 報導了這次推出。報導形容這個介面「不必碰 Python 或試算表」,就能測試不同的預算分配,並立刻看到預估 ROI。報導也點出它的目標對象:手邊沒有資料科學團隊隨時支援的行銷人。
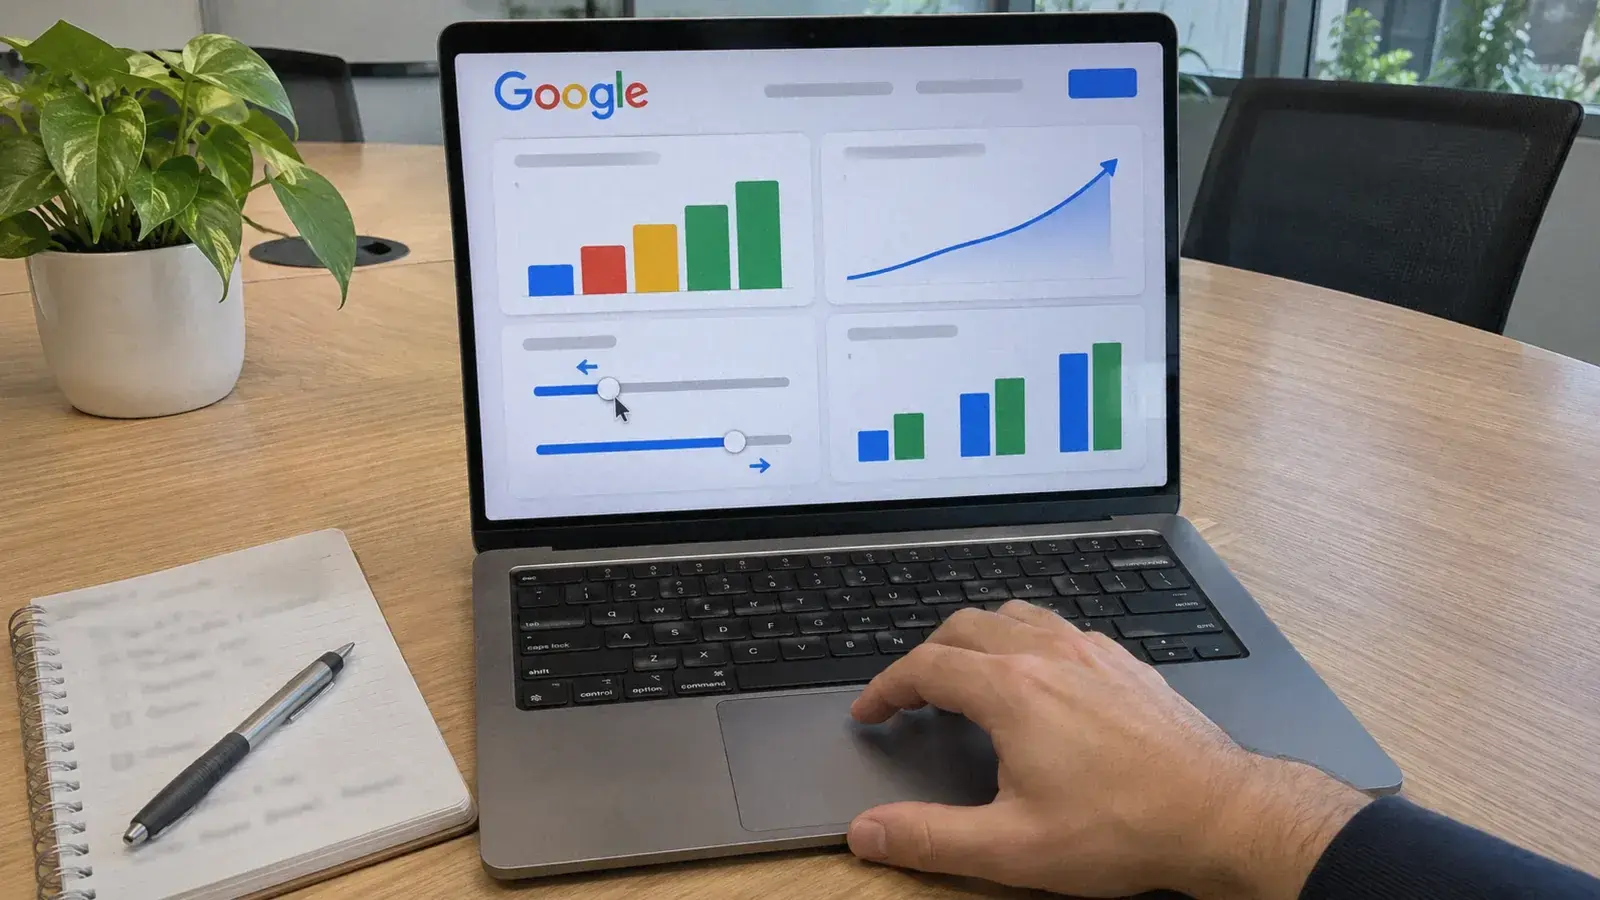
具體來說,預算情境模擬做的事情像這樣。你把搜尋廣告的預算往下拉一點,把影音廣告往上拉一點。畫面會告訴你模型預估的總營收怎麼變。過去這種試算要請分析師改參數重跑,現在行銷經理自己就能在會議上操作。
但它還做不到一件事:替你建模型。Scenario Planner 讀的是已經跑完的模型輸出。GitHub 公告同時推出 Unified Schema,用途是讓模型在不同系統之間分享。換句話說,介面降低的是「看」與「試」的門檻,建模那一段的門檻還在。
資料量也是門檻。資料基礎建設與 AI 分析廠商 Kleene.ai 的 MMM 指南在常見問答寫到,建模需要至少 24 個月的花費與銷售紀錄,最好更多。如果你的公司兩年內換過電商平台,或廣告帳號拆得很散,光是把資料整理齊就要花不少時間。
那 Google 為什麼要特別為非技術人員做介面?答案在模型跑完之後的那一段。
為什麼 MMM 跑完了,預算會議還是照舊?
MarTech 引用《哈佛商業評論》的資料指出,將近 40% 的組織難以把 MMM 的發現轉成實際決策。廣告服務商 AI Digital 文章引述的調查則顯示,87% 的行銷人認為 MMM 重要,自評「非常有效」能及時轉成決策的只有 28%。
這兩組數字講的是同一件事。大家都知道 MMM 有用,卡住的是轉譯。分析師交出一份報告,裡面是係數、信賴區間和飽和曲線。行銷主管看完點點頭,下一季的預算還是照著平台後台的 ROAS 分。
AI Digital 文章引述的調查:87% 的行銷人認為 MMM 重要,自評「非常有效」能及時轉成決策的只有 28%。
中間這段落差,就是 Scenario Planner 想填的地方。當主管可以自己拉滑桿、自己看預估結果,報告就從「別人算給我看的數字」變成「我自己試過的方案」。後者在預算會議上的說服力完全不同。
可是介面只解決一半。同一篇 AI Digital 文章還提到兩個數字。第一,47% 的受訪者表示,想根據 MMM 採取行動時,最主要的障礙是資料品質。第二,能有效使用 MMM 的組織裡,65% 至少每季更新一次模型。
這兩個數字對預算情境模擬的意義很實際。資料品質不好,模型的預估就不可信,介面做得再漂亮,拉出來的也是錯的方向。模型一年才更新一次,情境模擬用的就是去年的市場。消費者行為一變,飽和曲線也跟著變。
以季節性很強的品類為例。年底檔期的搜尋廣告可能還沒飽和,到了淡季同樣的預算就已經推不動。如果模型只用全年平均去估,預算情境模擬給出的建議會兩邊都不準。所以「每季更新」決定了情境結果能不能用。
所以真正的問題變成:模型要回答什麼,才值得拿進會議?
預算情境模擬要看邊際 ROI,平均 ROAS 只說明過去
AI Digital 在媒體組合最佳化文章裡把重點講成兩句話:平均 ROI 告訴你哪些管道有效過,邊際 ROI 告訴你下一塊錢放在哪裡最有力。
同一篇文章還有一句更直白的話:下一塊錢幾乎從來賺不到平均報酬。這句話值得多想一下。平台後台給你的 ROAS 是平均值。它把最早、最便宜的那批轉換和最後、最貴的那批混在一起算。
舉例來說,某個管道整體 ROAS 看起來很漂亮。可是如果它已經接近飽和,再多投的那一筆錢,換回來的可能遠低於平均。只看平均值,你會繼續往這個管道加碼,然後納悶為什麼總營收沒有跟著長。
AI Digital 把管道狀態分成兩區。飽和區是曲線已經走平的地方,每多一塊錢都接近浪費。投入不足區則是報酬還在爬升,多給預算賺回來的比花出去的多。預算情境模擬最有價值的用法,就是找出哪些錢卡在飽和區,再試算把它們移到投入不足區會發生什麼。
那平台歸因報表還有用嗎?有,但要換個位置。行銷科技服務商 House of MarTech 的量測框架文章寫得很清楚:MTA 在 MMM 劃定的範圍內做最佳化。也就是說,各管道之間的預算由 MMM 決定,管道內部要投哪組素材、哪個受眾,再交給多觸點歸因去調。
| 方法 | 負責的決策 | 在預算情境模擬中的角色 |
|---|---|---|
| MMM | 策略層的預算分配 | 產出飽和曲線,是情境試算的基礎 |
| MTA | 管道內的戰術最佳化 | 在 MMM 劃定的預算內調素材與受眾 |
| 增量測試 | 驗證前兩者 | 校準模型,讓情境預估有實驗根據 |
表格最後一列是很多團隊漏掉的。模型預估再精緻,也只是根據歷史資料推出來的關係。要讓它站得住,得有實驗結果撐腰。
用增量測試校準模型,情境才有根據
Google 官方部落格寫明,Meridian 能把增量實驗的結果當成先驗匯入,不限管道,也不限實驗類型。模型因此可以用真實世界的結果校準。
incrementality testing(增量測試)把受眾分成看得到廣告與看不到廣告兩組。比較兩組的結果差距,就能量出廣告真正多帶來的那一部分。
為什麼這一步這麼重要?House of MarTech 的文章提到,針對大型廣告帳號的研究發現,多數情況下 MTA 模型對數位管道的功勞高估超過 30%。原因是點擊路徑只看得到線上接觸點。線下的影響、自然搜尋、私下轉傳的連結,全都算不進去。
MMM 雖然不靠個人追蹤,卻有自己的盲點。它從歷史資料找相關性。如果兩個管道總是同時加碼,模型很難分出到底是誰的功勞。增量測試補的就是這個:用實驗直接量出因果,再回頭修正模型的估計。
The most defensible approach combines MMM for strategic budget allocation, MTA for tactical in-channel optimization, and incrementality testing to validate both.
翻成中文,意思是最站得住的做法,是三者搭配:MMM 管策略預算,MTA 管管道內戰術,增量測試負責驗證前兩者。
那要花多少錢做實驗?行銷顧問 Sandy Riev 在 2026 成效行銷操作手冊裡給了一個具體建議:把 10% 的預算分配給增量測試。同一份手冊也列出兩個常見的 MMM 工具:2025 年 1 月全面開放的 Google Meridian,以及開源的 Meta Robyn。
這份手冊也引用了 eMarketer 2024 年 7 月的資料:53.5% 的美國行銷人已經在用 MMM。換句話說,在美國市場,MMM 已經是一半以上行銷人手邊的工具,差別只在有沒有校準。
前提是實驗設計要乾淨。對照組太小,或測試期間剛好撞上檔期,實驗結果本身就有偏差。把有偏差的結果當先驗餵進模型,預算情境模擬只會更自信地給出錯的答案。所以第一次做,建議從預算最大的單一管道開始,測試期避開大促。
模型校準好了,最後一關是把結果講給握有預算的人聽。
把預算情境模擬的結果翻成 CFO 聽得懂的話
行銷與顧客體驗媒體 CMSWire 作者 Gary Lyng 在 2026 年 5 月的文章建議用「1 美元法則」向主管報告。他給的例句是:每花 1 美元,帶來 50 美元的管線與 20 美元的營收。
這個寫法好在哪?它用財務部門熟悉的單位講行銷數字。曝光、點擊、互動率,CFO 很難判斷值不值得。投入一塊錢回來多少錢,這個就能直接跟其他部門的提案比。
他在同一篇文章提到,行銷預算佔營收的比例在 2024 到 2025 年停在 7.7%。預算不再成長,每一筆錢都要跟別的部門搶。他也引用數據指出,每季跟 CFO 對齊一次的 CMO,在景氣下行時保住預算的機率高出 2.3 倍。
他的框架叫 5 A:Align、Architect、Activate、Articulate、Arbitrate。對應到中文,大致是對齊、架構、啟動、表述、權衡。跟預算情境模擬最直接相關的是 Articulate,也就是把行銷活動連結到營收結果。
預算情境模擬剛好能產出這種語言。它給的答案長這樣:「如果把多少錢從甲管道移到乙管道,預估總營收會怎麼變」。這就是一份可以直接帶進財務會議的提案。
實際準備時,我們建議帶三個情境去開會。第一個是維持現狀,當作基準。第二個是模型建議的最佳分配。第三個是保守版本,只移動一小部分預算。三個並排,CFO 看得到上限,也看得到風險。
例外在於模型還沒校準的時候。沒有經過增量測試驗證的情境,本質上只是另一種平台報表,只是畫面比較好看。這種狀態下拿去跟 CFO 談,反而容易在被追問時失分。順序要對:先校準,再試算,最後才翻成財務語言。
銷波快觀點:先分清哪些變數模型看得到
我們看數據下滑時,習慣先把因素分成兩類:直接可控的,像素材、文案、銷售頁;間接不可控的,像競爭對手、社群氛圍、整體環境。
Scenario Planner 處理的幾乎全是第一類。你能拉的滑桿,就是你能控制的預算。可是模型預估失準的時候,原因常常落在第二類。對手突然大舉投放,或整個產業被負面新聞籠罩,曲線就不會照模型走。以金融業為例,整個市場被詐騙新聞籠罩時,可以用廣告主動跟詐騙公司做出區隔,打破既定印象。這時要問的是:現有策略能不能回應那個間接因素?我們把這叫做「間接因素產生出的直接因素的調整」。
第二個提醒跟排序有關。我們自己做內容規劃時踩過一次:用既有的點擊去排優先順序,看起來很合理,結果系統性地漏掉了最大的市場。因為那些市場從來沒被碰過,點擊當然是零。用「現在有什麼」排序,等於讓過去的錯誤決定未來的順序。
預算也是一樣。MMM 只看得到有歷史花費的管道。從來沒投過的管道,模型給不出曲線,情境模擬裡也不會出現。所以模型說的「最佳分配」,是在你過去做過的選項裡挑最好的。要不要開新管道,還是得靠小規模的實驗去探。
第三,別只拿總 ROI 比。漏斗上層負責引流,下層負責收網,兩者的預算角色本來就不同。以 Meta 廣告為例,上層通常設 Awareness、Reach 或 Video Views 目標,下層才集中在轉換。上層的錢看起來報酬低,卻在餵養下層的受眾池。情境模擬時把上層砍光,短期數字可能變好,幾個月後下層就沒人可收。
最後,預算分配解決的是流量端。我們常說,一個流量技術加一個轉換技術,才是一套完整的收單機制。FB 廣告、SEO、短影音屬於流量技術,銷售頁與 LINE 預約屬於轉換技術。如果轉換頁本身就在漏,模型建議加碼的管道,只會把更多人送進漏水的轉換頁。拉滑桿之前,先確認轉換那一端撐得住。
結論:先校準再拉滑桿,預算情境模擬才算數
Scenario Planner 把預算情境模擬搬進 Looker Studio,解決的是轉譯問題,模型品質的問題它管不到。
現在就能做的事有三件。先盤點自己有沒有 24 個月以上、格式一致的花費與銷售資料。再挑預算最大的一個管道,設計一次增量測試。最後才把校準過的模型接上 Scenario Planner,帶著三個情境去找 CFO。
順序反過來也做得到,畫面一樣漂亮。差別在於被財務追問的那一刻,你手上有沒有實驗結果可以拿出來。
喜歡這篇?讓行銷變好懂,訂閱銷波快。
資料來源
- Introducing Meridian Scenario Planner: Turn Insights into Actiongithub.com
- Meridian marketing mix model is now available to everyoneblog.google
- Google launches no-code Scenario Planner built on Meridian MMMmartech.org
- Media Mix Optimization: Using MMM for Smarter Budget Allocationaidigital.com
- Marketing Mix Modeling vs Multi-Touch Attribution: Privacy-First Measurement Framework for 2026houseofmartech.com
- The Performance Marketer’s 2026 Playbook: AI, Attribution and ROI in a Post-Hype Worldsandyriev.com
- How CMOs Can Defend Marketing Budgets in the AI Eracmswire.com
- AI Media Mix Modeling Guidekleene.ai